같은 AI, 다른 결과 — 성패를 가르는 건 AI 모델이 아니라 데이터 연결 구조입니다
안녕하세요. AI 소통 협업툴 써팀(SirTEAM)입니다😊 지난해 11월 2000여 개 글로벌 기업을 대상으로 진행된 한 설문조사에 따르면, 응답 기업의 62%가 AI 에이전트를 실험 중이라고 답했습니다. 하지만 그중에서 전사 확산 단계에 도달한 기업은 10% 미만에 그쳤습니다. AI에 대한 관심과 실험은 빠르게 늘고 있지만, 실제 업무 안에 정착시키는 일은 전혀 다른 문제입니다. 많은 팀이
- 작성자
- SirTEAM
- 발행일
- 읽는 시간
- 약 4분
안녕하세요. AI 소통 협업툴 써팀(SirTEAM)입니다😊
지난해 11월 2000여 개 글로벌 기업을 대상으로 진행된 한 설문조사에 따르면, 응답 기업의 62%가 AI 에이전트를 실험 중이라고 답했습니다. 하지만 그중에서 전사 확산 단계에 도달한 기업은 10% 미만에 그쳤습니다. AI에 대한 관심과 실험은 빠르게 늘고 있지만, 실제 업무 안에 정착시키는 일은 전혀 다른 문제입니다. 많은 팀이 AI를 도입하고도 "생각보다 별로다"라는 결론에 이르는 이유, 대부분은 모델의 한계가 아닙니다. 아래 글에서 그 이유에 대해 확인해보세요!
데이터 연결이 모델보다 먼저인 이유
AI 정확도를 좌우하는 건 어떤 모델을 쓰느냐가 아니라, 그 모델이 무엇을 참고하느냐입니다. 사내 문서가 어떤 형태로 존재하는지, 사용자의 질문 의도에 맞는 정보를 어떻게 찾는지, 검색된 정보를 어떤 방식으로 AI에 전달하는지에 따라 최종 답변의 품질이 달라집니다. 같은 ChatGPT를 사용하더라도 어떤 팀은 실무에 바로 활용할 수 있는 답변을 얻는 반면, 어떤 팀은 엉뚱하거나 일반적인 답변만 반복해서 받는 이유가 여기에 있습니다.
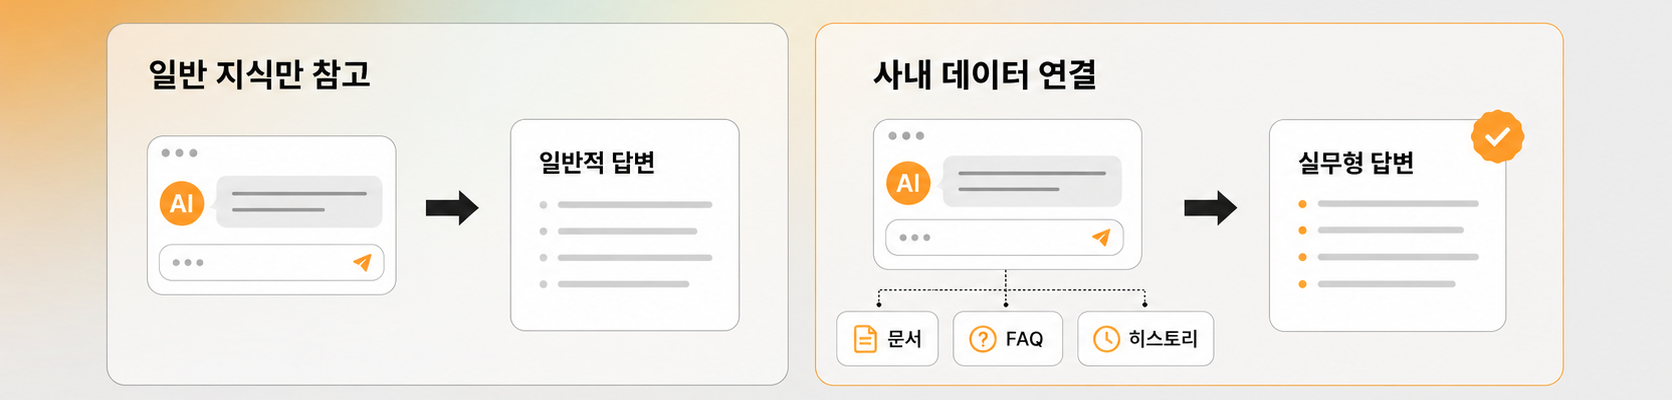
이 구조를 이해하는 데 도움이 되는 개념이 RAG(Retrieval-Augmented Generation, 검색 증강 생성)입니다. AI가 답변을 생성할 때 학습된 일반 지식에만 의존하는 것이 아니라, 조직 내부의 실제 데이터를 검색해 참고하는 방식입니다. 쉽게 말해 AI에게 우리 팀의 맥락을 먼저 읽힌 뒤 답변하게 하는 것인데요. 이전 글에서 다뤘던 AI 레디 데이터 개념과 맞닿아 있습니다. AI가 실질적인 도움을 주려면 조직 내부의 데이터가 먼저 연결 가능한 형태로 갖춰져 있어야 한다는 것이죠.
👉 AI 레디 데이터란? AI가 우리 팀 업무를 이해하게 만드는 방법 보러가기
데이터가 구조화되지 않으면 생기는 일
예를 들어 고객 문의가 하나 들어왔다고 해보겠습니다. 담당자는 메일을 확인하고, 관련 자료를 드라이브에서 찾고, 이전 논의 내용을 메신저에서 검색하고, 답변 초안을 별도 AI 툴에서 작성한 뒤 다시 메일로 옮깁니다. 데이터는 분명히 조직 안에 존재하지만, 문제는 그 데이터가 메일, 드라이브, 메신저, 위키에 각각 흩어져 있다는 점입니다.
AI는 연결되지 않은 데이터를 참고할 수 없기 때문에, 결국 사람이 직접 자료를 끌어모아 AI에게 붙여넣어야 하는 상황이 생기는 것이죠. 그렇게 만들어진 결과물을 다시 메일로 옮기는 과정이 반복됩니다. AI를 쓰는데 손은 줄지 않고, 오히려 확인해야 할 창이 하나 더 늘어나는 상황이 생깁니다. 글로벌 기업의 62%가 AI를 실험하고 있지만 전사 확산까지 간 곳이 10%에 그치는 배경에는 이 구조적 문제가 있습니다. AI 자체의 한계가 아니라, AI가 참고할 수 있는 데이터가 연결되지 않은 채로 도입만 먼저 이뤄진 결과입니다.
써팀의 2단계 구조 — 지식을 쌓고, AI가 그 위에서 작동한다
사실 데이터 연결이 중요하다는 것을 알아도 실제 실행 단계에서는 또 다른 문제가 생깁니다. AI가 활용할 수 있도록 기존 문서를 따로 모으고 정리하는 과정 자체가 구성원에게 새로운 업무가 될 수 있기 때문입니다. 한 번 데이터를 정리하는 것보다 더 어려운 일은, 이후에도 최신 상태로 계속 유지하는 것입니다. 따라서 AI를 위해 별도의 데이터 저장소를 만드는 방식보다는, 구성원이 평소 업무를 수행하는 공간 안에서 지식이 자연스럽게 축적되고 그 지식을 AI가 바로 활용할 수 있는 구조가 필요합니다. 문서를 작성하고 수정하는 일상적인 업무가 곧 데이터 정리가 되고, 그렇게 쌓인 정보 위에서 AI가 작동해야 데이터와 실제 업무 사이의 간극도 줄일 수 있기 때문인데요.
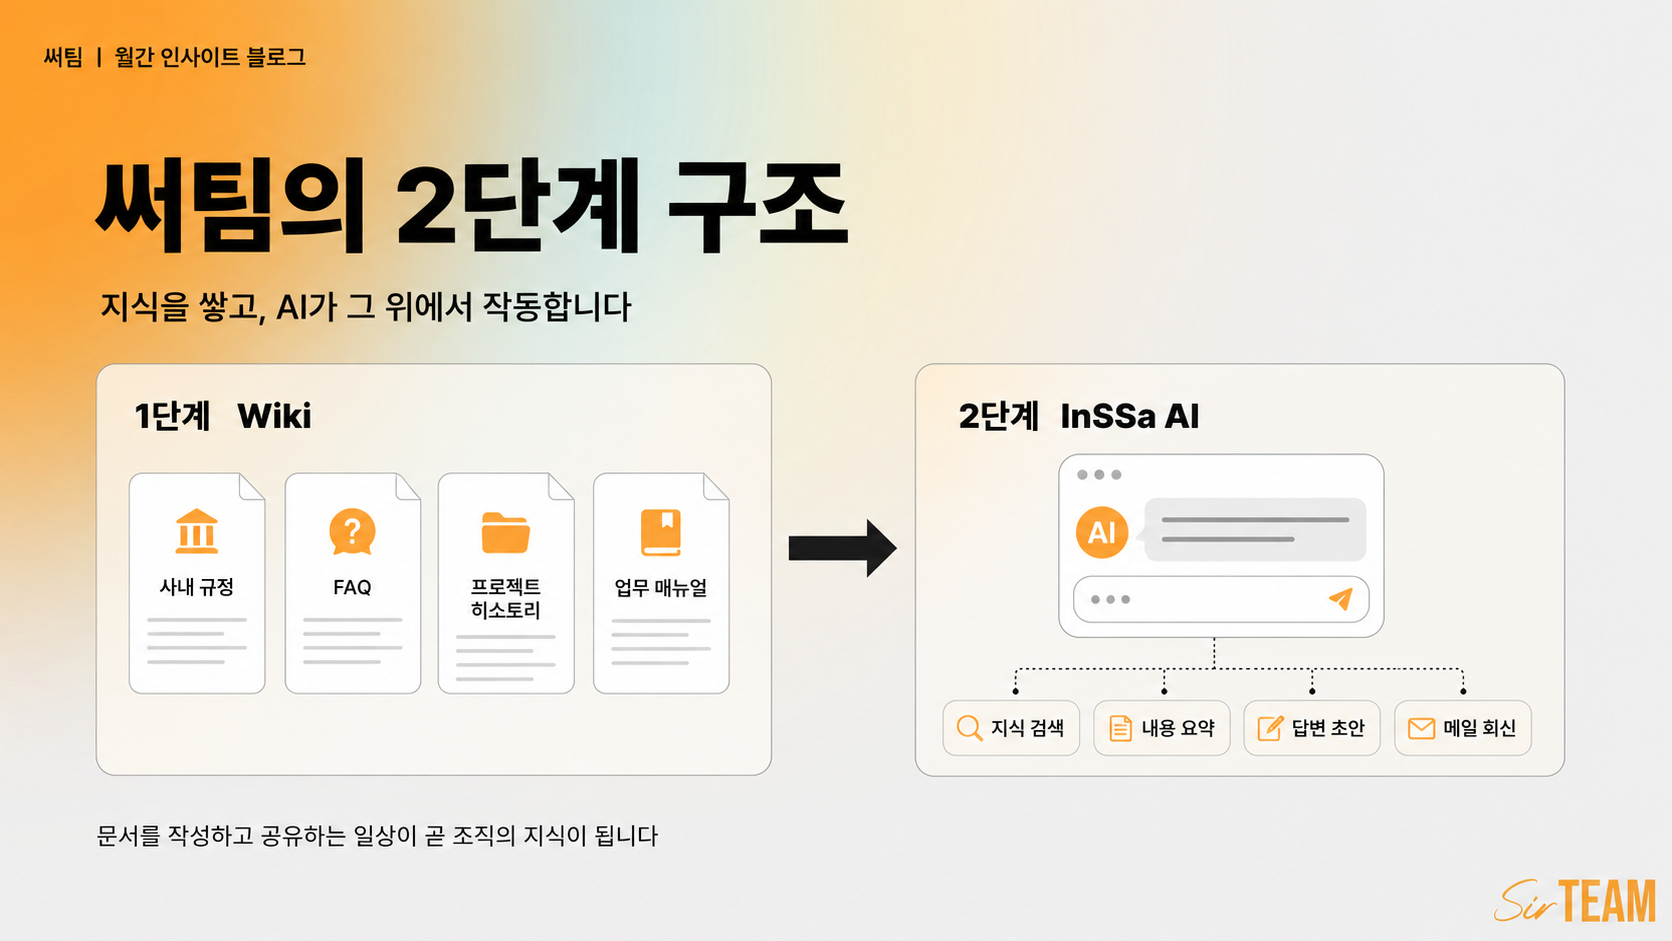
써팀은 이를 위키와 InSSa AI가 연결된 2단계 구조로 구현합니다. 첫 번째 단계는 위키(Wiki)로 조직의 지식을 구조화하는 것입니다. 사내 규정 문서, 프로젝트 히스토리, 대외비, FAQ처럼 팀마다 다른 문서들을 위키에 정리합니다. 별도의 AI용 데이터베이스를 다시 구축하는 것이 아니라, 구성원이 평소 문서를 작성하고 공유하는 과정에서 조직의 지식이 한곳에 축적됩니다.
두 번째 단계는 InSSa AI가 이렇게 구조화된 지식 위에서 작동하는 것입니다. 구성원은 InSSa AI에 자연어로 질문하는 것만으로 사내 위키의 관련 내용을 찾아 요약할 수 있으며, 이를 바탕으로 메일 회신 초안까지 바로 작성할 수 있습니다. 예를 들어 고객 문의가 들어왔을 때 담당자가 메일, 드라이브, 메신저를 오가며 관련 자료를 직접 모을 필요가 없는 것이죠. InSSa AI가 위키에 축적된 정보를 찾아 필요한 맥락을 정리하고, 이를 기반으로 답변 초안을 작성합니다. 신규 직원 역시 방대한 업무 매뉴얼을 처음부터 모두 읽는 대신 자연어 질문을 통해 필요한 내용을 빠르게 파악할 수 있습니다.
즉, 써팀에서는 문서를 작성하고 공유하는 일상적인 업무가 조직의 지식을 쌓는 첫 번째 단계가 되고, InSSa AI가 그 지식을 실제 업무에 활용하는 두 번째 단계가 됩니다. 고객 문의 확인부터 내부 지식 검색, 내용 요약, 답변 작성까지의 흐름이 하나의 업무 맥락 안에서 끊기지 않고 이어지는 구조입니다.
AI 성과는 모델이 아니라 구조에서 납니다
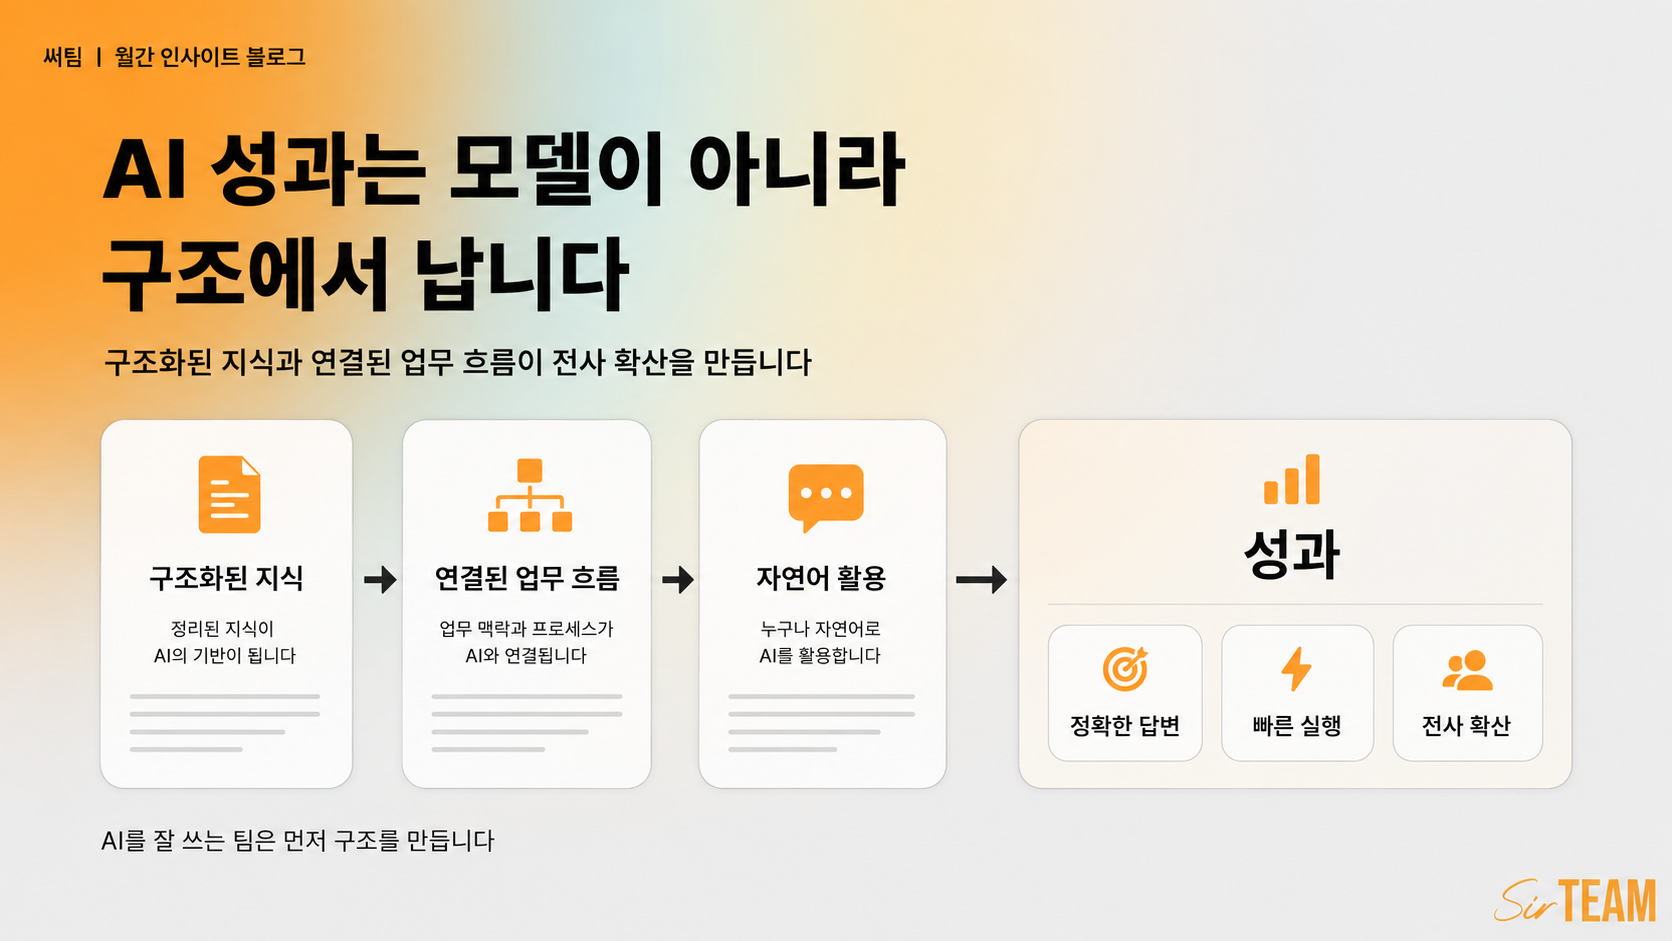
AI 도입 실험은 빠르게 늘고 있지만 전사 확산까지 가는 곳이 10%에 그치는 이유, 결국 모델의 문제가 아닙니다. AI가 참고할 수 있는 데이터가 구조화되어 있는지, 조직의 업무 흐름 안에 자연스럽게 연결되어 있는지가 성패를 가릅니다. 최신 모델을 도입하기 전에 먼저 던져야 할 질문은 하나입니다. 우리 팀의 지식이 AI가 읽을 수 있는 형태로 쌓이고 있는가. 그 구조를 갖춘 팀이 AI를 가장 잘 활용하는 팀이 됩니다.
써팀의 위키 × InSSa AI 기반 업무 방식이 궁금하시다면, 지금 바로 경험해보세요!
📞 070-7018-0030